문서의 세부 정보를 검색에 남긴다
퍼플렉시티가 2026년 10월 6일 공식 블로그에서 새로운 멀티모달 검색 모델 pplx-embed-v2-late를 소개했다. 0.6b와 9b라는 이름의 두 모델은 텍스트뿐 아니라 이미지와 시각적 문서를 검색 대상으로 삼는다. 가중치는 Hugging Face에 공개됐으며, 회사는 Perplexity API 지원을 이후 순차 제공할 계획이라고 설명한다. 공개 가중치와 호스팅 API의 이용 가능 시점은 구분해야 한다. 공식 발표
공식 모델 카드는 MIT 라이선스와 토큰당 128차원 벡터를 안내한다. 질의와 문서의 토큰 표현을 MaxSim 방식으로 비교하는 late-interaction 구조다. 두 모델은 임베딩 공간을 공유하므로 9b로 만든 문서 인덱스를 0.6b로 질의하는 구성도 가능하다고 설명한다. 공식 모델 카드
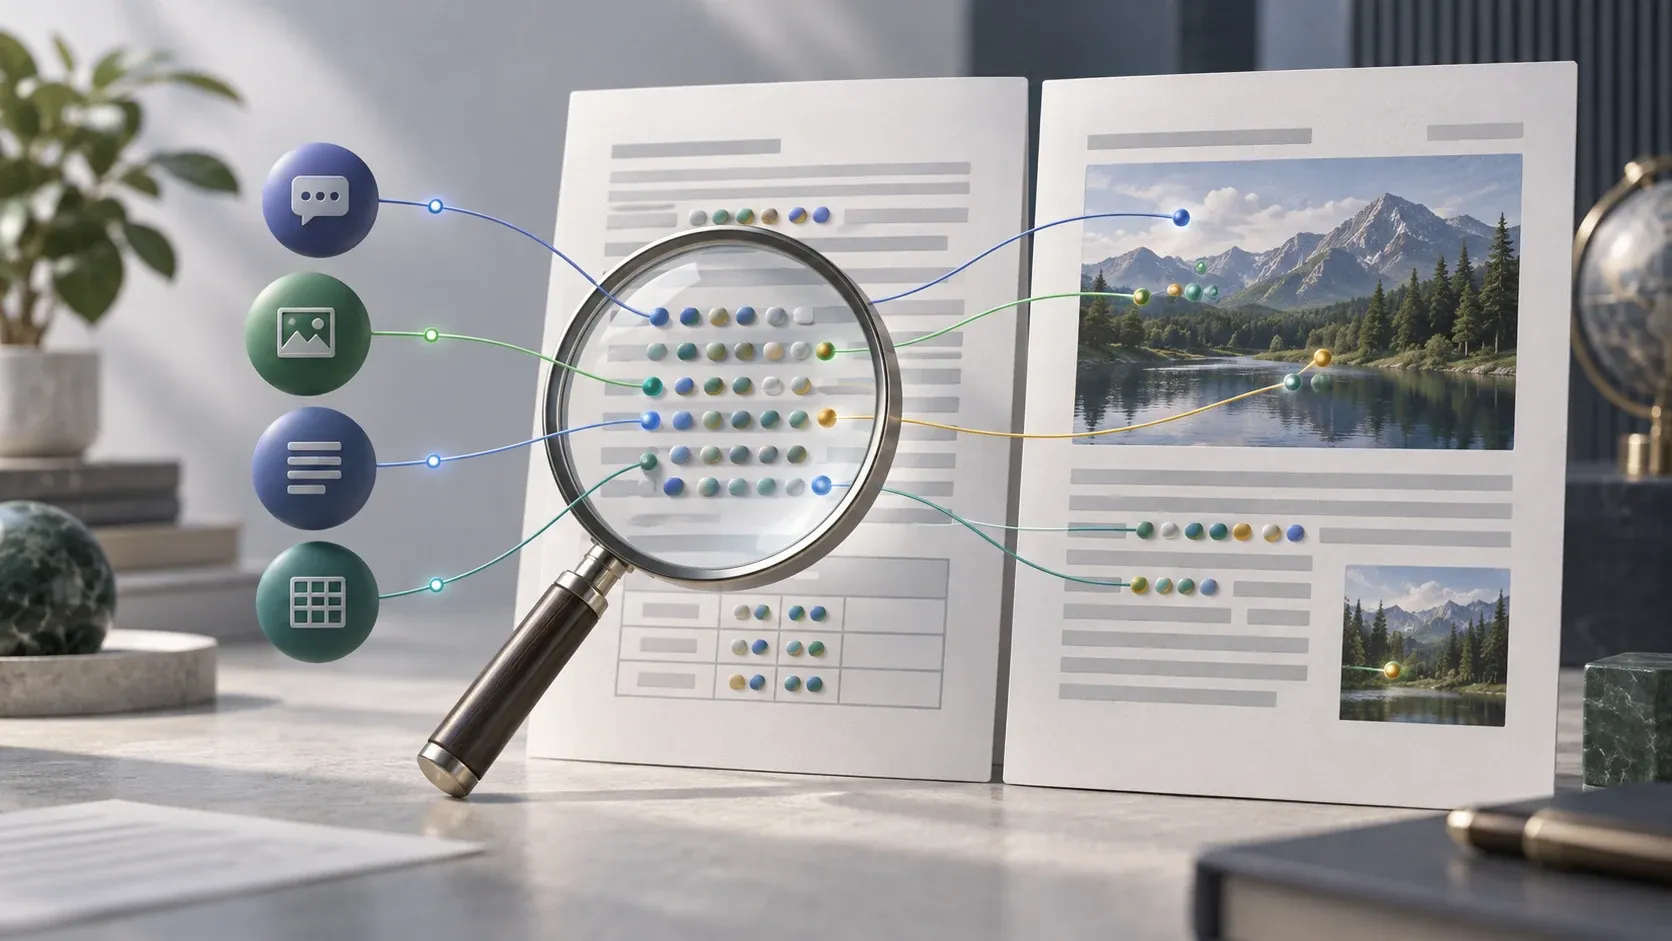
검색어의 세부 요소와 문서 속 텍스트·표·이미지를 대응시키는 멀티모달 검색.
PDF 검색에서 관심을 끄는 이유
편집팀은 이번 공개를 문서의 시각적 구조를 검색에 활용하려는 흐름으로 본다. 가상의 제품 설명서에는 본문 문장뿐 아니라 표, 그림, 주석이 함께 있다. 텍스트만 추출하면 표의 열 관계나 그림과 설명의 연결이 약해질 수 있다. 문서 페이지를 시각 자료로 다루는 검색은 이런 자료에서 비교할 후보가 된다.
다만 관련 페이지를 찾는 것과 그 안의 수치를 정확히 읽는 것은 다른 작업이다. 검색 시스템이 올바른 페이지를 반환해도, 답변 모델이 표의 단위나 각주를 놓칠 수 있다. 따라서 검색 평가와 최종 답변 평가는 따로 진행해야 한다.
모델 크기를 나눠 쓰는 설계
문서 인덱스 생성은 자료를 등록하거나 갱신할 때 수행하고, 질의 처리는 사용자가 질문할 때마다 반복한다. 두 단계의 빈도와 지연시간 요구가 다르므로 서로 다른 모델을 사용하는 구상은 운영 측면에서 살펴볼 가치가 있다. 이는 제품 설명을 바탕으로 한 해석이며, 특정 구성의 비용 절감을 측정한 결과는 아니다.
비교를 위해서는 같은 문서 집합과 질문을 준비할 수 있다. 표에서 근거를 찾는 질문, 그림의 설명을 찾는 질문, 유사한 문서 중 최신 버전을 찾는 질문을 나눠 평가하면 어디서 차이가 생기는지 파악하기 쉽다.
| 평가 항목 | 확인할 결과 |
|---|---|
| 관련 자료 검색 | 답의 근거가 있는 페이지가 반환되는가? |
| 운영 비용 | 색인 저장량과 질의 처리량은 얼마인가? |
| 답변 정확성 | 수치·단위·출처가 원문과 일치하는가? |
토큰별 벡터를 저장하는 방식은 단일 벡터 검색과 운영 조건이 다를 수 있다. 검색 품질뿐 아니라 인덱스 크기, 갱신 시간, 실제 질문의 응답 지연을 함께 측정해야 서비스 적용 여부를 판단할 수 있다.
자주 묻는 질문
대화형 답변을 만드는 모델인가?
주된 역할은 관련 자료를 찾기 위한 표현과 유사도 비교다. 답변 작성에는 별도의 생성 모델이나 애플리케이션 구성이 필요하다.
API에서도 바로 사용할 수 있나?
공식 발표는 API 지원을 향후 순차 제공할 계획으로 설명한다. 현재 공개 가중치를 사용하는 경로와 구분해서 확인해야 한다.
두 크기의 모델을 섞어 사용할 수 있나?
공식 모델 카드는 공유 임베딩 공간을 안내한다. 실제 구성에서는 같은 자료를 색인한 뒤 대표 질문으로 검색 결과를 비교할 수 있다.
PDF 검색이 좋아지면 답변도 항상 정확해지나?
그렇지는 않다. 검색한 근거를 읽고 인용하는 단계에서 오류가 생길 수 있다. 관련 페이지 포함 여부와 답변의 원문 일치 여부를 각각 검증해야 한다.
한눈에 정리
pplx-embed-v2-late는 텍스트와 시각 문서 검색을 위한 공개 모델군이다. 도입팀은 가중치와 API 제공 시점을 구분하고, 검색 품질·저장량·질의 비용·최종 답변 정확성을 함께 비교할 수 있다.